Попросіть Nano Banana 2 намалювати Хрещатик, і ще до появи першого пікселя вона може зробити те саме, що зробила б людина, яка ніколи не була в Києві, – залізти в Google. Модель вміє підтягувати з пошуку реальну інформацію та зображення і вже на їхній основі будувати картинку. Звучить, можливо, не так разюче, але саме в цьому її головна особливість.
Google випустив Nano Banana 2 наприкінці лютого і майже одразу зробив її моделлю за замовчуванням у Gemini. Тож я вирішив порівняти її з першою Nano Banana, дав обом однакові завдання і подивився, наскільки велика різниця між моделями.
ЧИТАЙТЕ ТАКОЖ:
Що в ній нового
Найбільша зміна стосується того, звідки модель бере уявлення про світ. Перша Nano Banana покладалася лише на те, що засвоїла під час навчання, а друга спирається на знання Gemini й може використовувати пошук Google, зокрема пошук зображень. Звідси кращі результати з реальними будівлями, технікою та предметами, які мають конкретний, впізнаваний вигляд, і вміння перетворювати нотатки на інфографіку чи діаграму.
Помітно підтягнули й текст – написи на згенерованих зображеннях довго були слабким місцем, кирилиця особливо, а Nano Banana 2 значно акуратніше відтворює типографіку, якщо точно вказати потрібний текст у лапках.
Змінились і робочі можливості – тепер роздільність від 512 пікселів до 4K, а модель тримає зовнішність до п’яти персонажів і до чотирнадцяти об’єктів в одній серії. Співвідношень сторін чотирнадцять, а референсних зображень можна завантажити до чотирнадцяти, тоді як перша версія приймала вісім.
Цифри цифрами, але цікавіше подивитися на результат. Щоб умови були рівними, обидві моделі отримували однакові промпти, однакове співвідношення сторін і роздільність 1K. Усі зображення в тесті – перші спроби, без перегенерацій і доопрацювання промптів.
Центр Києва
Почнімо з реального місця. Обидві моделі отримали детальний опис вечірнього Хрещатика після дощу.
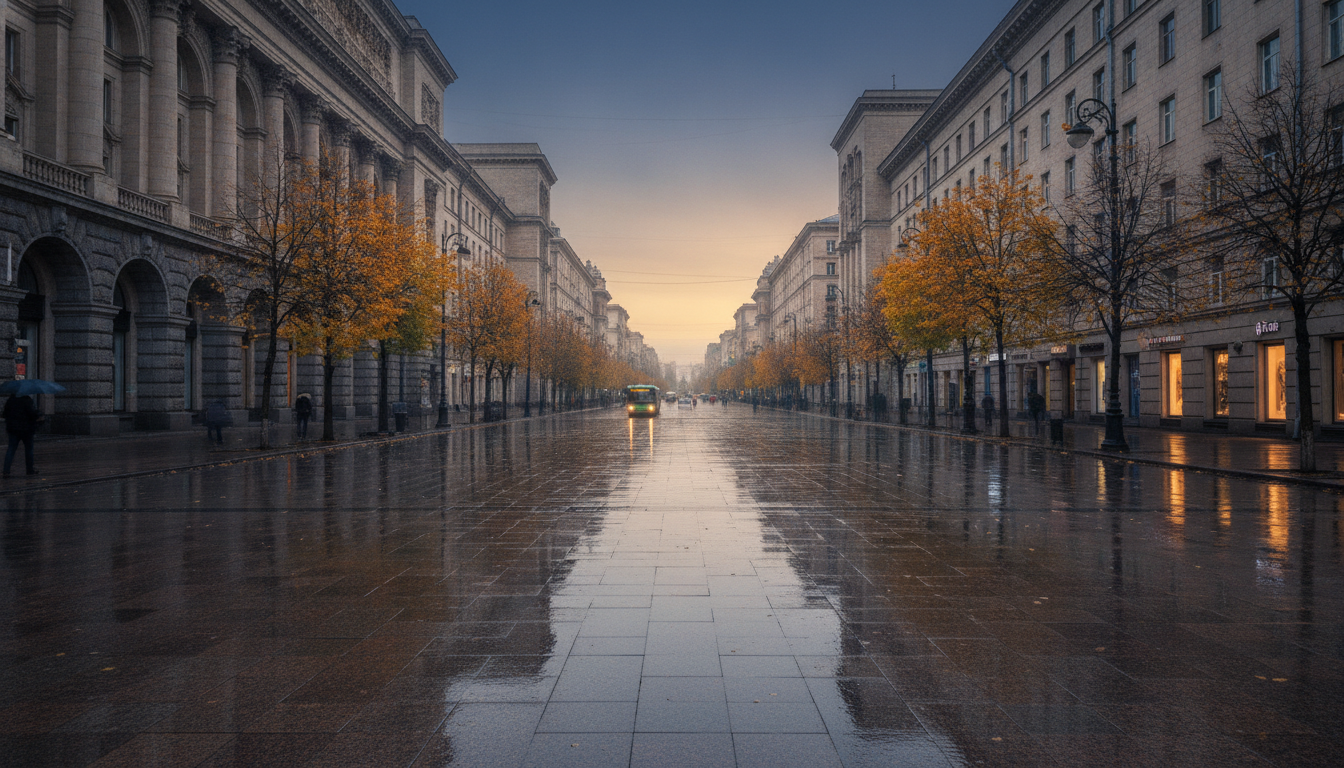
Перша версія намалювала широкий бульвар з масивними будівлями, який більше нагадує узагальнене пострадянське місто, ніж Хрещатик. Проїжджої частини фактично немає, вулиця перетворилася на суцільну мокру площу.
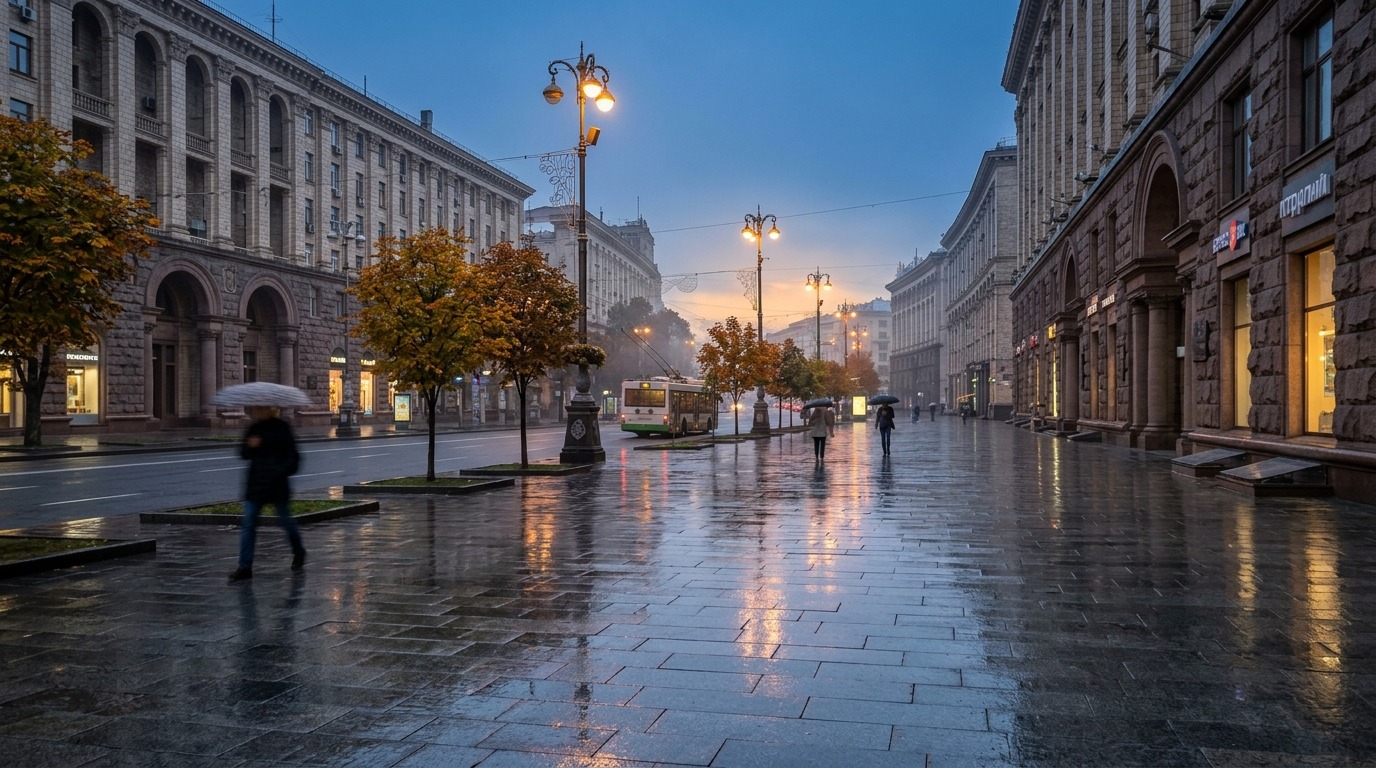
Друга версія впізнає Хрещатик з першого погляду. Гранітні фасади з арками, ліхтарі, клумби вздовж тротуару, розділена проїжджа частина і тролейбус мають такий вигляд, ніби кадр зняли на телефон під час вечірньої прогулянки. Генерацію видають лише спотворені вивіски на фасадах.
Автомобіль на нічній вулиці
Автомобіль – класична перевірка для генератора. Пропорції кузова, геометрія фар, відблиски на лакованій поверхні й відображення міста в калюжах складно намалювати переконливо.
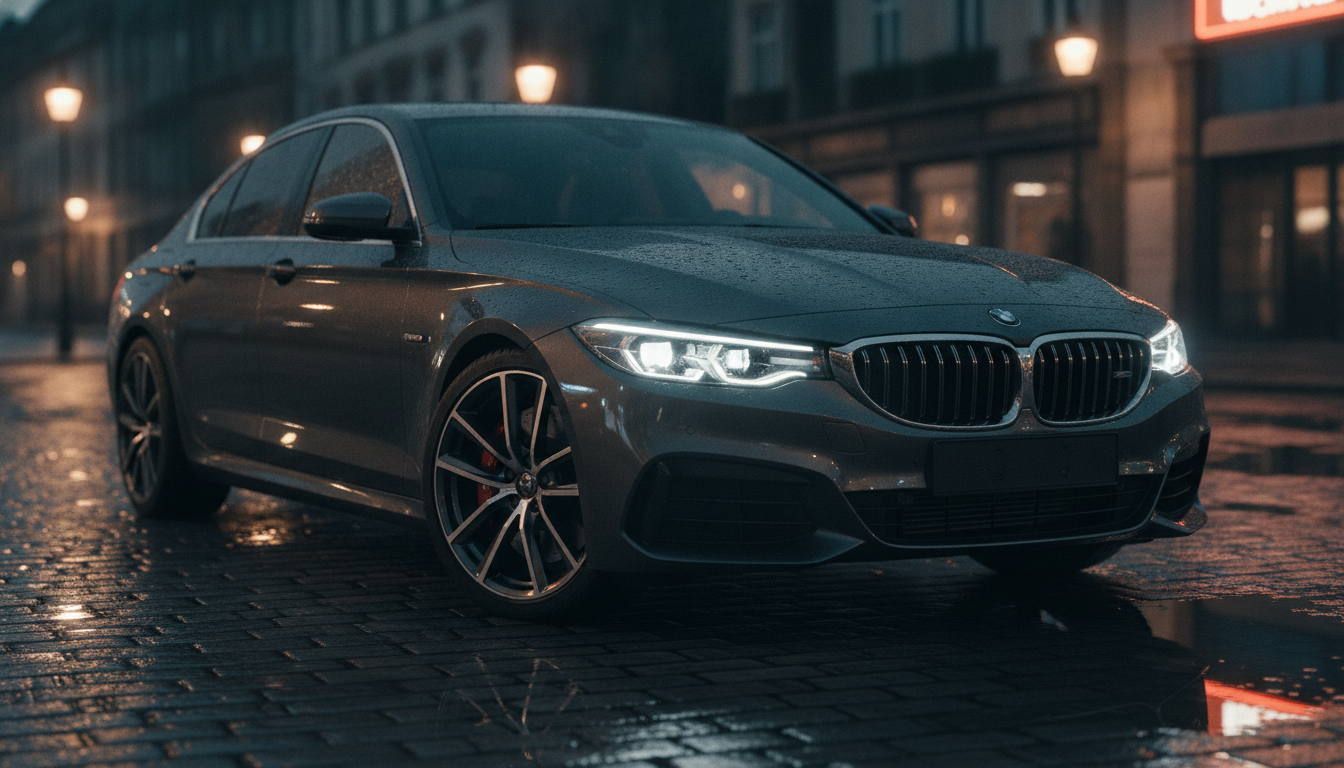
Перша версія проігнорувала прохання обійтися без логотипів і намалювала BMW з емблемою на капоті. Сама машина вийшла охайною, але має вигляд рендеру. Світла мало, відображення приглушені, а місто довкола ледь проглядається.
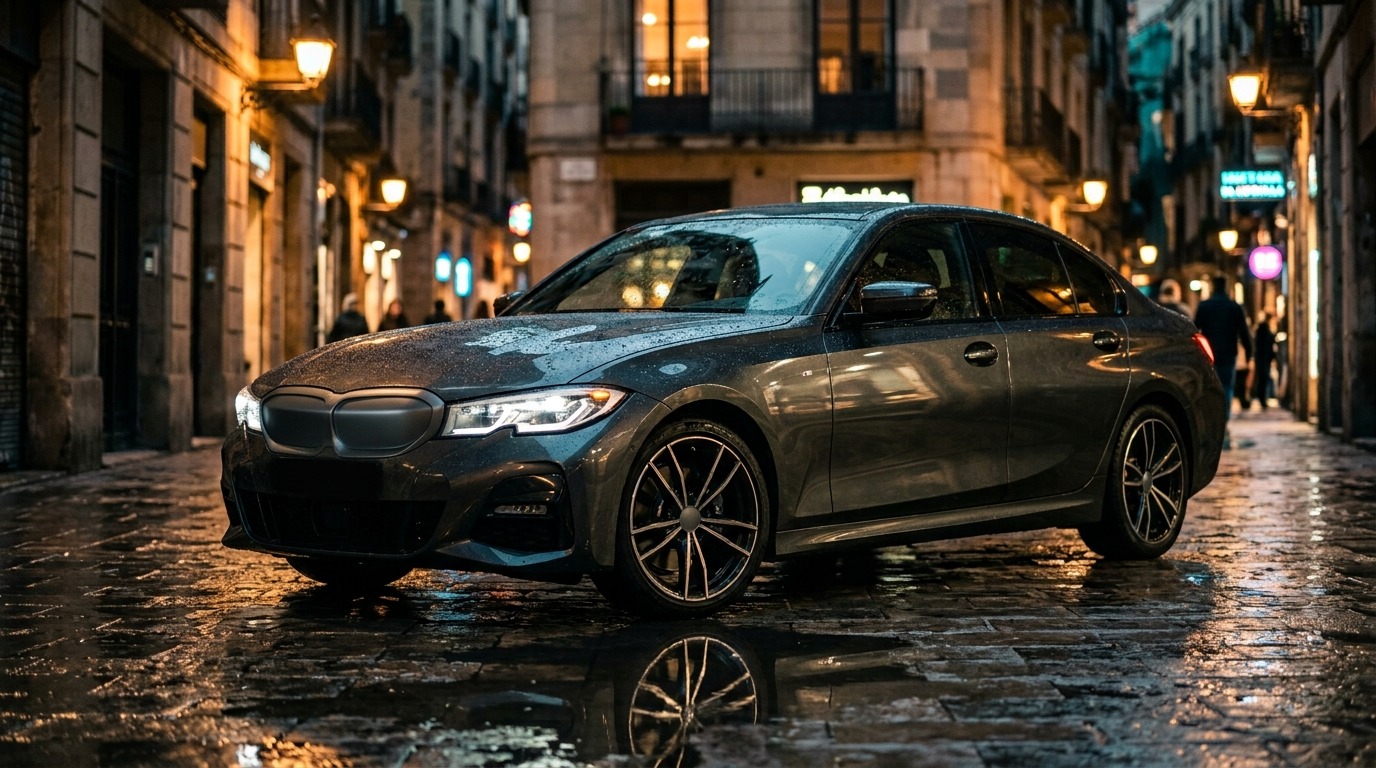
Тут теж упізнаваний силует BMW, але емблему модель прибрала, тобто інструкцію виконала. Головна різниця в атмосфері. Вузька старовинна вулиця з перехожими, вітрини, ліхтарі та диск, що віддзеркалюється в калюжі, роблять кадр схожим на справжню нічну фотографію. Видає ШІ хіба що решітка радіатора, яка перетворилася на суцільну пластикову заглушку без ламелей.
Бронежилет і каска з написом “ПРЕСА”
Тут два завдання в одному. Модель має правдоподібно відтворити спорядження, де багато дрібних деталей на кшталт ременів, липучок і кріплень, і написати українське слово на вигнутій поверхні каски, а не на пласкому тлі.
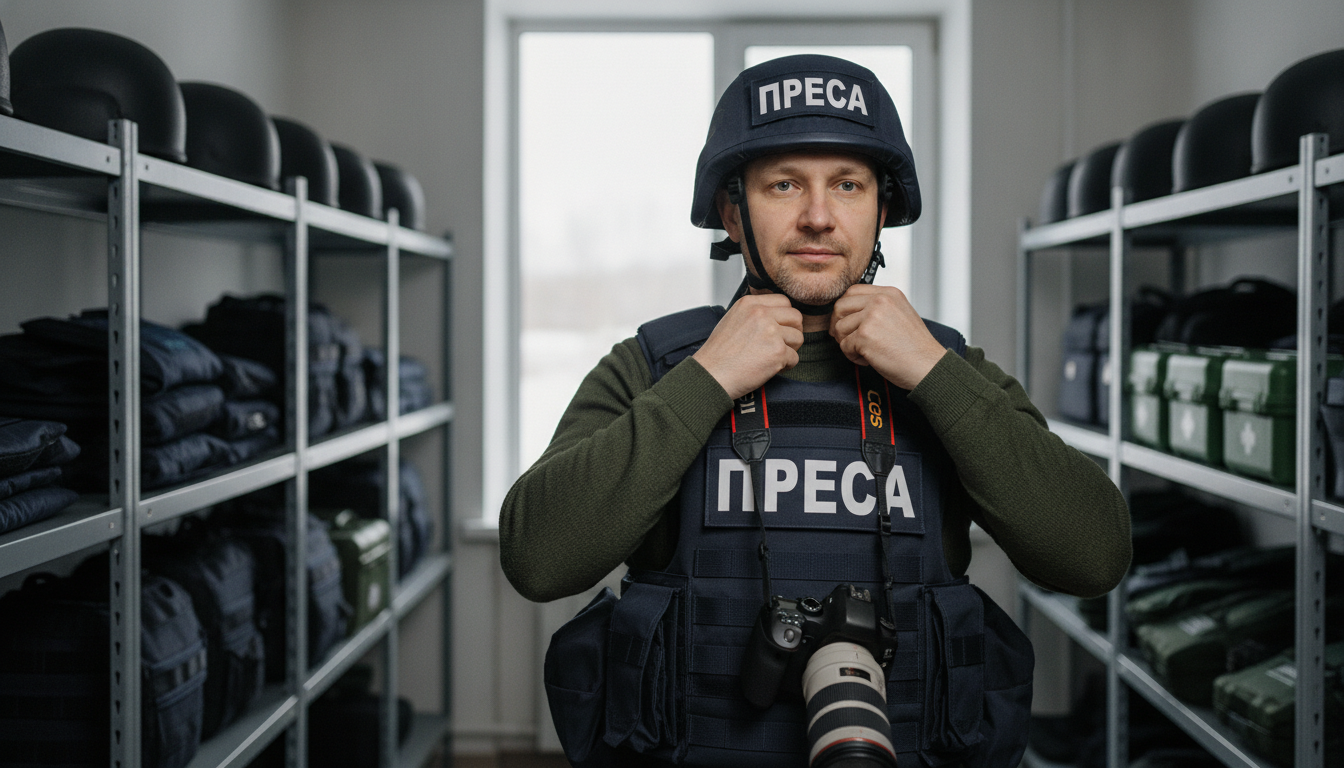
Слово “ПРЕСА” перша версія написала без помилок і на жилеті, і на касці, і це вже непоганий результат. Але композиція надто постановна, журналіст стоїть майже як на рекламному плакаті, а камера висить на грудях, хоча в промпті вона мала бути на плечі. Полиці з касками й аптечками на тлі видаються однотипними, ніби їх скопіювали.
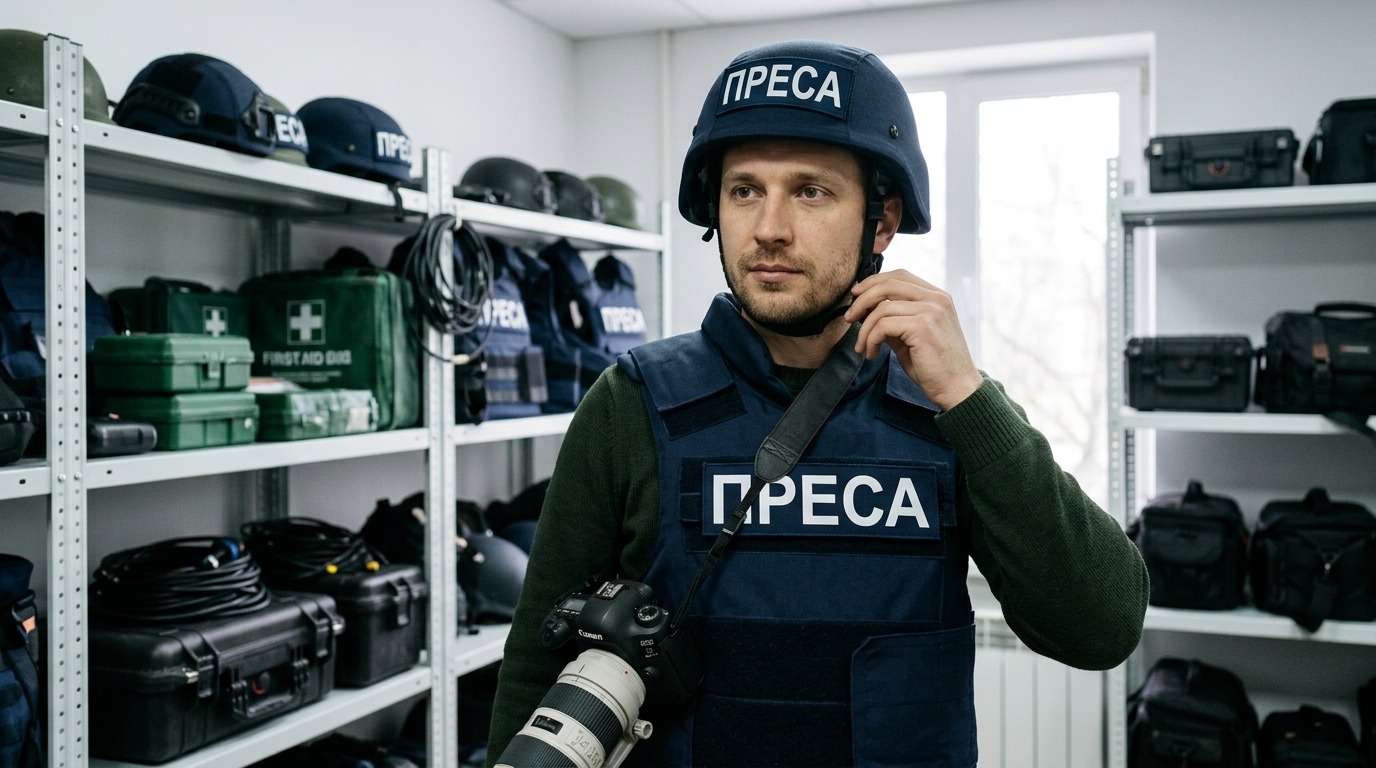
Друга версія теж бездоганно впоралася з написом, але пішла далі. Камера висить на плечі, як я і просив, поза природна, а на тлі з’явились інші жилети й каски з тим самим написом “ПРЕСА”, тож модель тримає тему в усьому кадрі.
Білборд з українським слоганом
Написати текст без помилок – одне, а вбудувати його в нормальний дизайн – зовсім інше. Цей тест буде найскладнішим. Білборд на вечірній київській вулиці з плакатом у стриманому мінімалістичному стилі, двома рядками українського тексту і чіткою ієрархією шрифтів.
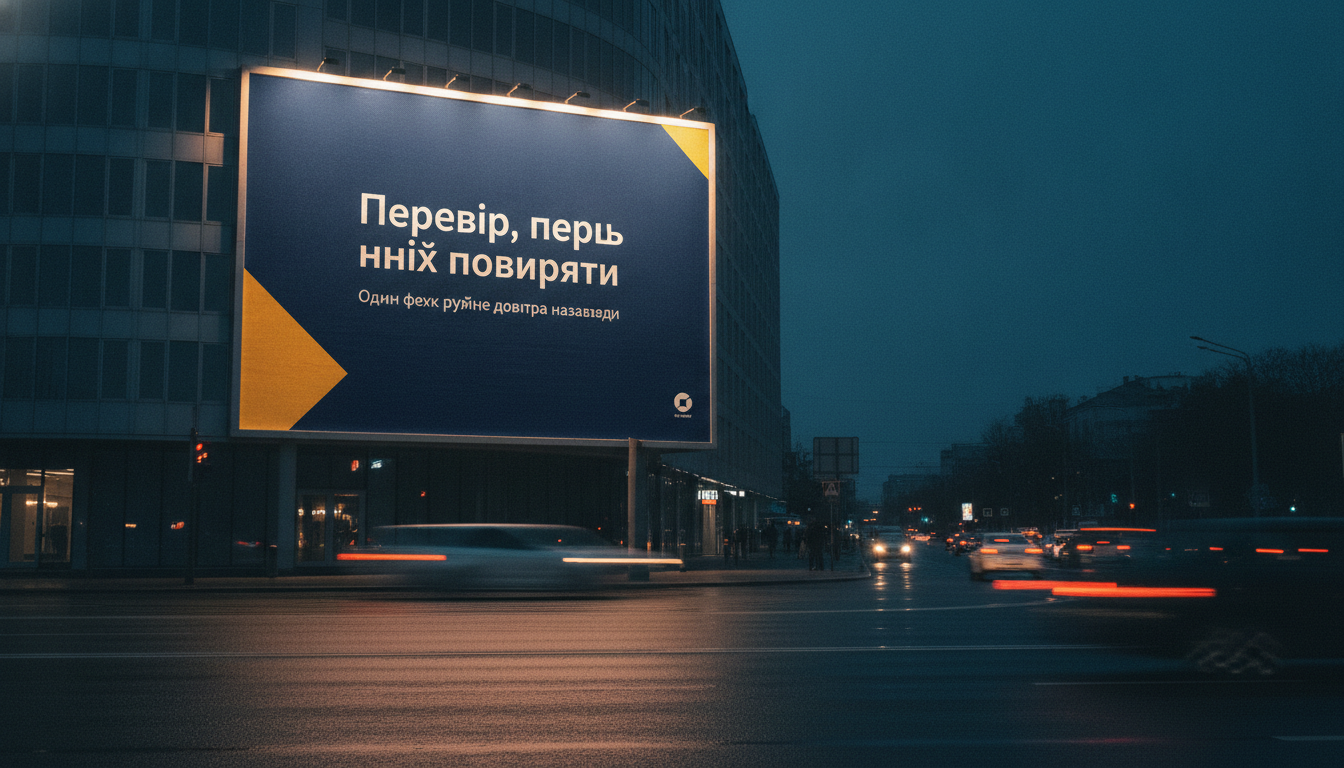
Повний провал, кирилична каша, а модель ще й додала логотип унизу, хоча я в промпті прямо просив обійтися без нього.
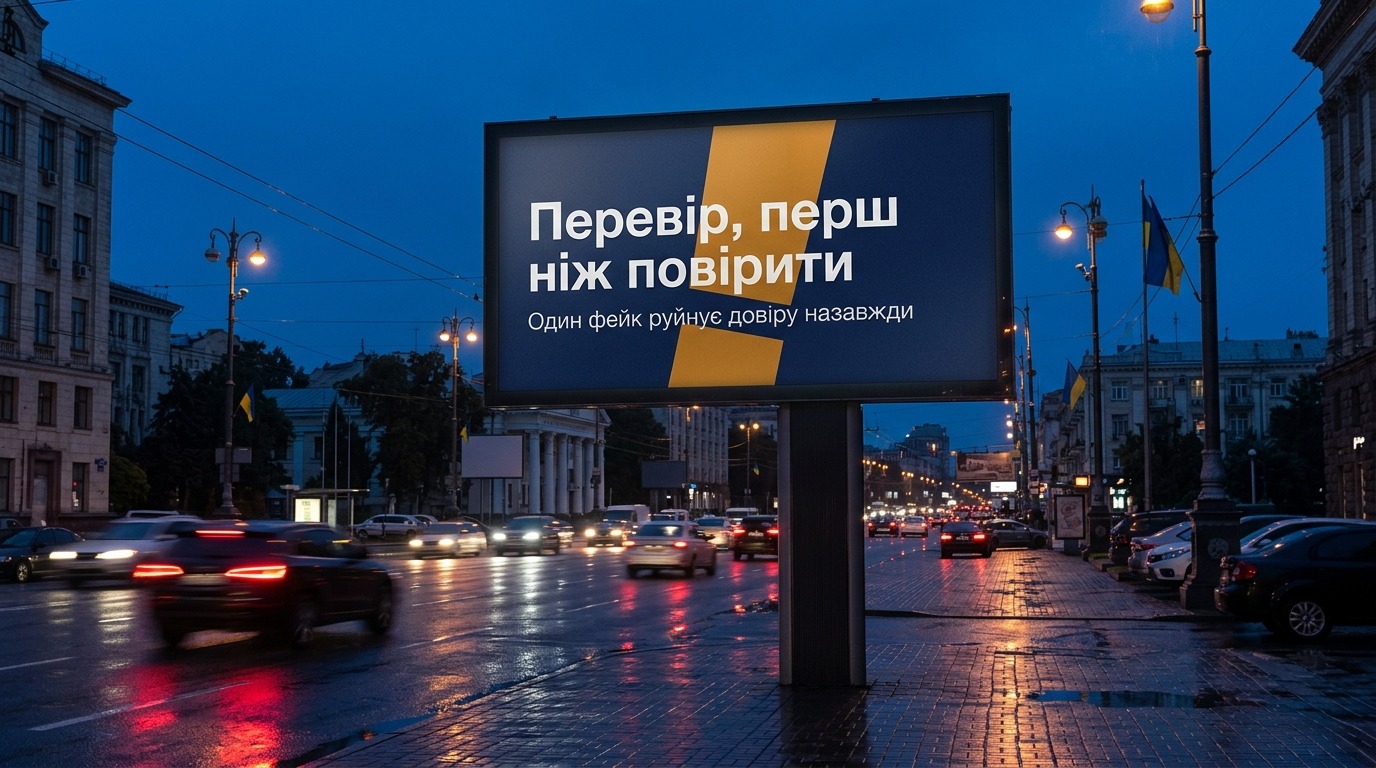
Все написано правильно. Жовтий акцент модель обіграла як знак оклику за текстом, що має вигляд гарного дизайнерського рішення. Довкола впізнавана київська вулиця з ліхтарями, колонадою й синьо-жовтими прапорами.
Вавилон
Хрещатик модель може підгледіти в пошуку, а от фотографій висячих садів Вавилона не існує, є лише описи античних авторів і реконструкції археологів. Обидві моделі отримали детальний промпт із висячими садами на семи терасах, Брамою Іштар, зикуратом Етеменанкі та Євфратом на передньому плані, тож спиратися їм довелося на власні знання про Месопотамію.
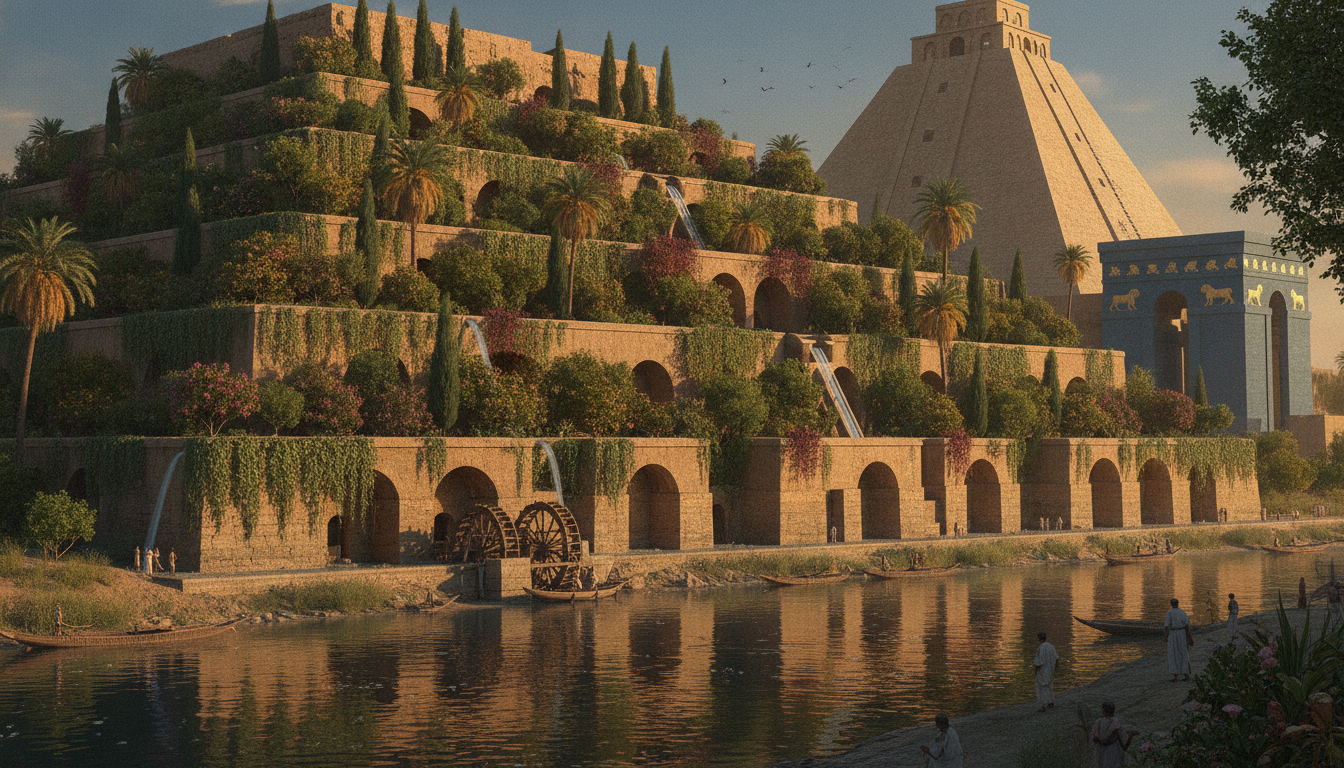
Із садами перша версія впоралася. Тераси з арками, кипариси, пальми, водоспади між рівнями та водяні колеса видаються ефектними. А от з рештою Вавилона проблеми. Замість східчастого зикурату вийшла гладенька піраміда з вежею на верхівці, більше схожа на єгипетську, а Брама Іштар перетворилася на синій павільйон, що стоїть впритул до садів. Загалом кадр нагадує радше ілюстрацію до фентезі-гри, ніж історичну реконструкцію.
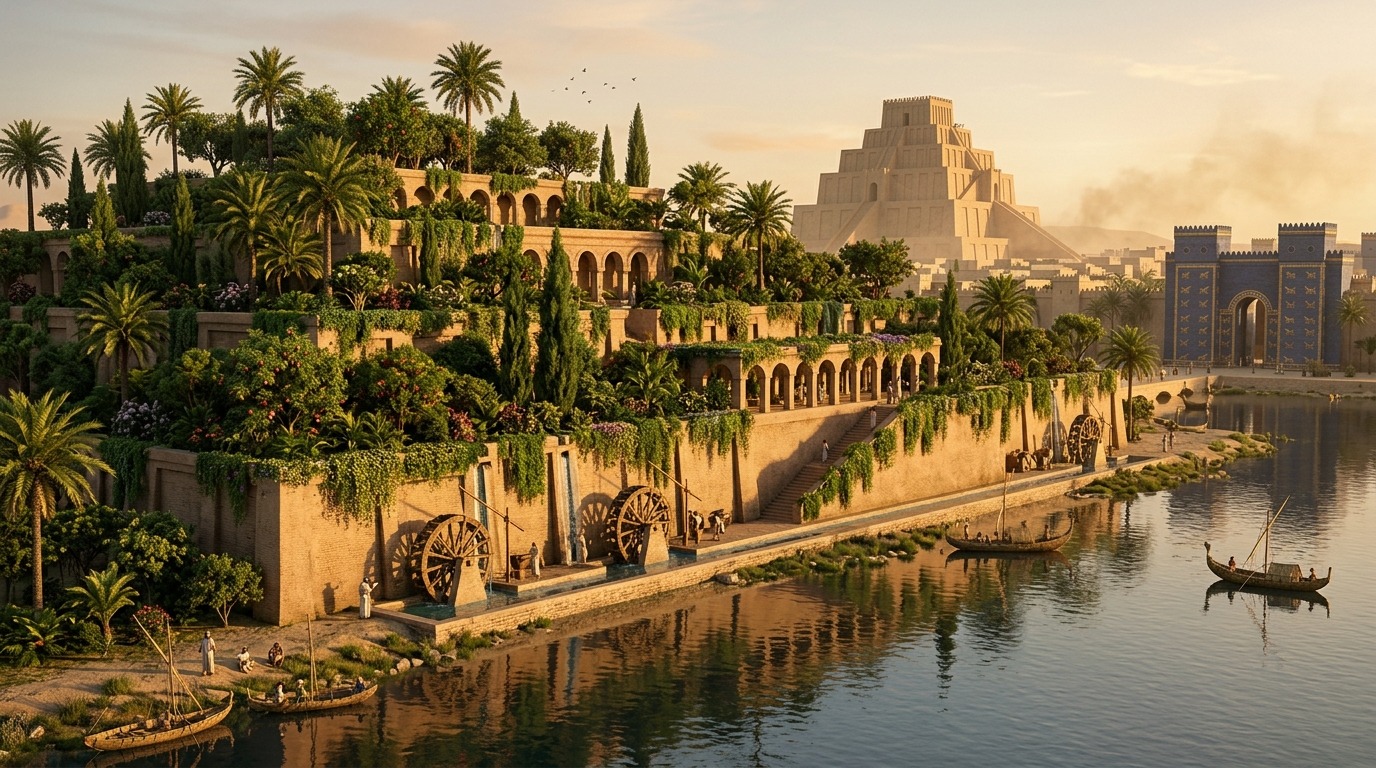
Друга версія знає Месопотамію значно краще. Зикурат східчастий, саме такий, яким його показують археологічні реконструкції, а Брама Іштар із зубчастими вежами та синьою глазурованою цеглою з рельєфами тварин впізнається одразу. Самі ж сади вийшли скромнішими, ніж у першої версії, терас помітно менше за сім, а водяні колеса стоять на платформі й до річки не дістають.
Де вона досі провалюється
Що більше в кадрі окремих об’єктів, то швидше модель починає здавати. На багатолюдній площі загальна композиція виходить переконливою, але варто збільшити другий план, і деталізація розсипається. Обличчя перетворюються на розмиті плями, руки живуть власним життям, дрібні вивіски знову стають текстом, якого не існує. Великі об’ємні сцени з десятками фігур і предметів Nano Banana 2 розуміє загалом, але в дрібницях програє.
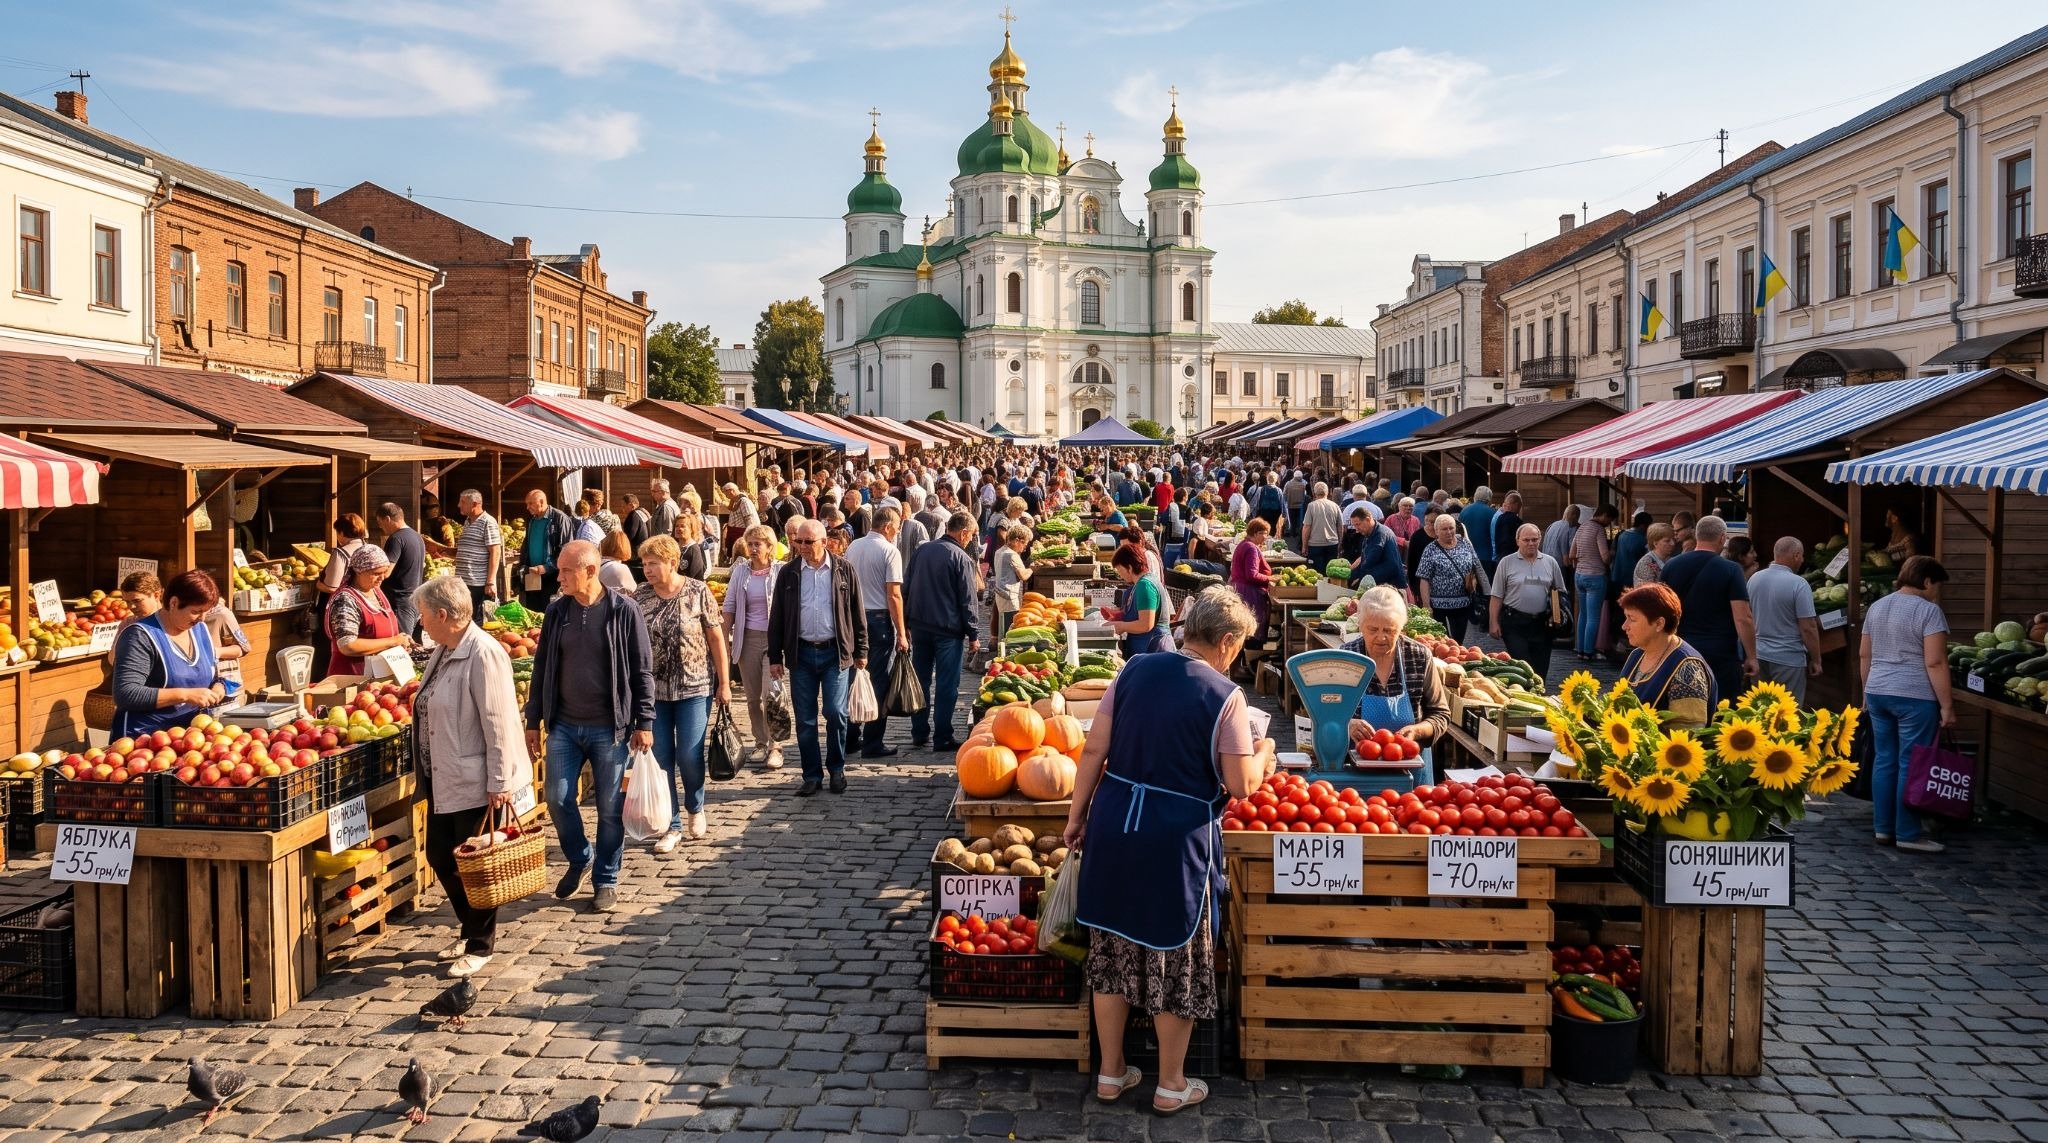
Загальний план вражає – бароковий храм, смугасті тенти, соняшники, гарбузи, а більшість цінників написані правильно, як-от “Яблука 55 грн/кг” чи “Помідори 70 грн/кг”. Але навіть на передньому плані трапляються дива, над помідорами чомусь висить табличка “Марія”, а під гарбузами – “Согірка”. Чи, може, це якийсь сорт?
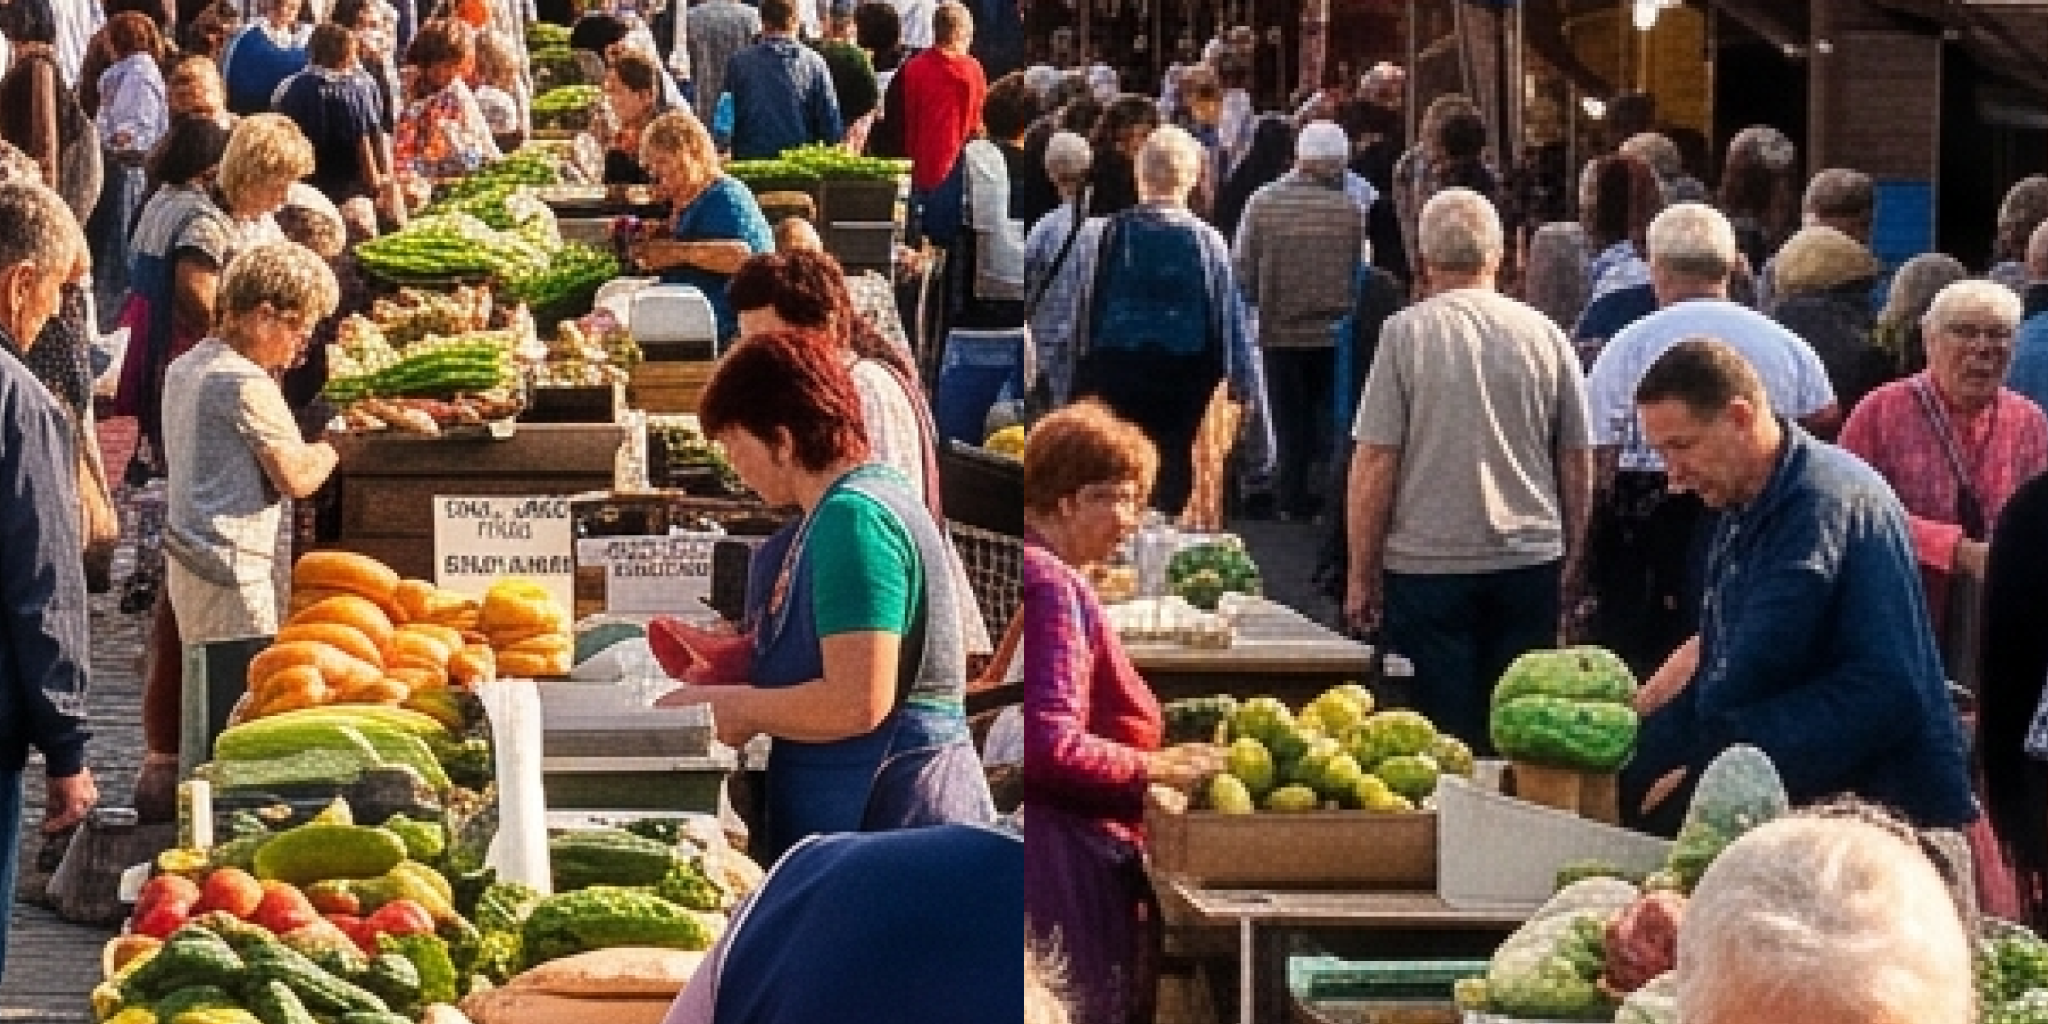
У збільшенні ілюзія розсипається. Обличчя на другому плані перетворюються на розмиті маски, люди зливаються в одну масу, овочі стають безформними плямами, а вивіски заповнені псевдолатиницею на кшталт “SHO, BACO”. Саме тут добре видно межу можливостей моделі.
Тож кожне зображення варто переглядати в повному розмірі.
Невидимий водяний знак
У кожне зображення від Nano Banana 2 Google вбудовує невидимий водяний знак SynthID і додає метадані C2PA Content Credentials, які зберігають інформацію про походження файлу. Перевірити картинку може будь-хто – досить завантажити її в застосунок Gemini й спитати, чи створена вона штучним інтелектом.
Де можна спробувати
Найпростіше – у застосунку Gemini, де Nano Banana 2 вже працює за замовчуванням. Для професійних налаштувань є Google AI Studio. Модель також доступна на сторонніх платформах, я користуюся Higgsfield. Чернетки та пошук ідеї зручно робити в 1K, бо це швидко, а фінальну версію перегенерувати у 2K або 4K.
Підсумовуючи
Якщо перша Nano Banana змінила саму філософію роботи з віжуалом, то друга змінює уявлення про те, що взагалі таке згенероване зображення. Модель більше не вигадує світ з пам’яті, а звіряється з ним, перш ніж намалювати. Вона знає, який вигляд має конкретна київська вулиця, як світло лягає на мокрий кузов і де в українському слові має стояти апостроф. Межа між фотографією і генерацією, яка ще нещодавно впадала в око з першого погляду, стала трішечки тоншою.
Модель уже вміє дуже багато, але досі потребує людини, яка знає, чого хоче, і бачить, де щось пішло не так.
Ігор Ісиченко